

Attention Is All You Need – #5:终于见到Attention!
上篇 ——从 QKV 到 Causal Mask
呼。。。。99MLP的研究暂时告一段落啦~
这篇博客咱们终于开始研究Transformer和Attention啦!
最终的目标是做出一个99GPT!!!
第一关正式开始!
假设有一句话:
小明把苹果放进书包,因为它太重了。
GPT问到:
如果神经网络要判断「它」指的是谁,你觉得它应该只分析「它」这个字本身,还是应该参考句子中的其他词?
以及,你觉得普通 MLP 能不能处理这种关系?为什么?
hmmm我觉得肯定要参考其他词,因为这个词是代词
像99mlp那样的,除非训练过很多次,巨量的训练能达到所需要的效果
GPT给的答案:
MLP 可以学习词与词的关系。 如果把整个句子的词向量输入一个足够大的 MLP,它确实有可能通过训练学会判断代词指代。
但普通 MLP 没有显式的、动态的词间注意力计算机制。 它通常依靠训练好的固定权重处理输入,而 Attention 能根据当前输入,动态计算各个词之间的关联程度。
一个非常关键的知识点
预测下一个词是一种训练目标,而 Attention 是一种网络计算机制。
Attention 到底是怎么做到的?
Attention 的一个核心思路就是:
让一个 Token 根据当前上下文,决定应该从哪些 Token 获取多少信息。
为了实现这个过程,Transformer 引入了三个向量:
| 名称 | 全称 | 直观理解 |
|---|---|---|
| Q | Query | 我正在寻找什么信息? |
| K | Key | 我有什么特征可供匹配? |
| V | Value | 我实际能够提供什么信息? |
注意,这只是便于理解的类比。Q、K、V 实际上都是通过可学习的权重矩阵,从 Token 的表示中计算出来的。
隆重请出!Attention公式!!
咱们先给个小情景,就用开头的那句话,有:
从里往外看
QK点积——计算匹配分数
-
Q:Query(查询矩阵)
-
K:Key(键矩阵)
-
K^T:Key 的转置矩阵
-
QK^T:通过矩阵乘法,计算各个 Query 和 Key 之间的点积相似度分数
所以:
这就是普通的点乘,矩阵乘法
为什么要除以\sqrt{d_k}?
d_k 表示 Key 向量的维度,也就是每次 Q、K 点积时相乘再求和的项数。
这个跟He初始化的理念很像
假如有 n 个相互独立的随机变量,每个方差为 1,那么它们相加的方差就是 n。
Attention 的点积是:
在一个简化假设下,设 Q、K 的各个分量相互独立、均值为 0、方差为 1。
那么:
因此:
这里我给我自己加个注解,每个q,k方差都是1,所以d_k个qk乘积加在一起方差就是d_k(方差的性质),所以d_k可以表达维度
维度越大,点积的典型波动幅度就越大!
比如 d_k=64,它的标准差就会达到 8。
这样直接送进 Softmax,很容易产生特别极端的分布,使梯度变得很小。
所以我们把它除以:
方差就变成:
这跟我研究权重初始化时,控制方差的思想非常相似!
回到我们的例子,d_k=2。
约等于:
Softmax——把分数变成注意力权重
softmax公式:
(我很好奇这个公式到底是如何产生的hhhh)
带入上一步算好的\frac{Q \cdot K}{\sqrt{d_k}}
我去!?加一块等于1!?
为什么 Softmax 输出的所有权重之和总是等于 1?
Softmax 输出的数字加起来等于 1,不是巧合,而是它的公式本身就保证了这一点!
我们直接从数学上证明!
因为每一项的分母相同,可以合并成:
注意,分子和分母其实是完全相同的求和!i、j 只是求和使用的下标。
所以:
原来是这样啊,Softmax传入的是一组数字,然后分子是e的当前元素次幂,然后分母是先计算e的每个元素次幂,再把这些结果相加
Value加权求和
把苹果句子的score带入到Softmax中
这就是注意力权重。
但问题来了:得到这些权重以后,Attention 究竟要输出什么?
答案:通过这些权重,对各个 Token 的 Value 向量进行加权求和。
假设现在有:
矩阵乘法:
得到:
矩阵O就是Attention最后输出的东西啦~
GPT的手算题目:
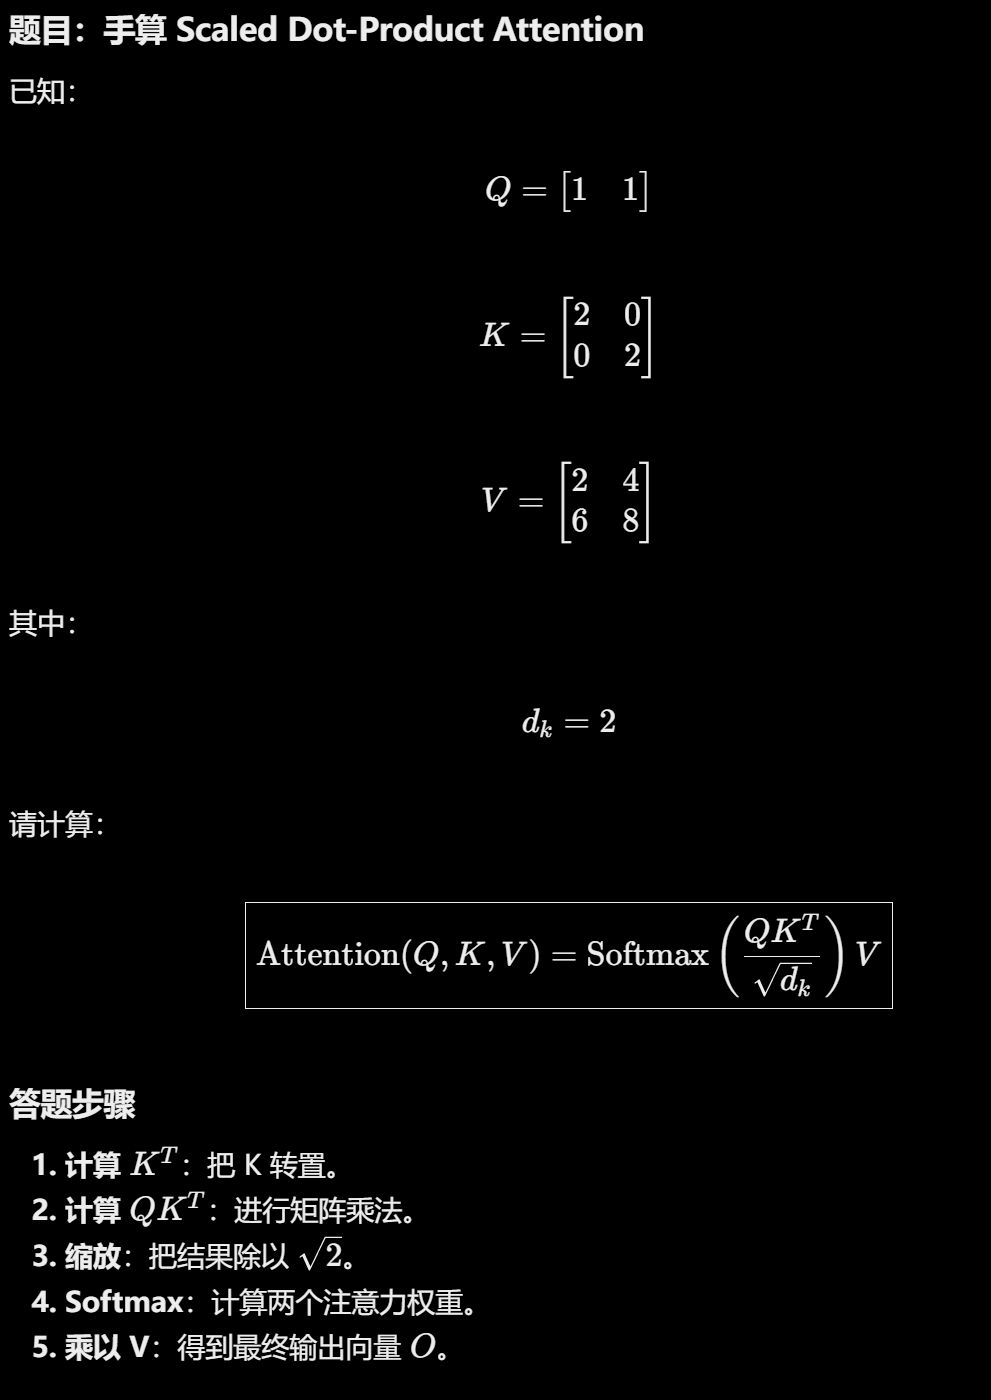
开干!
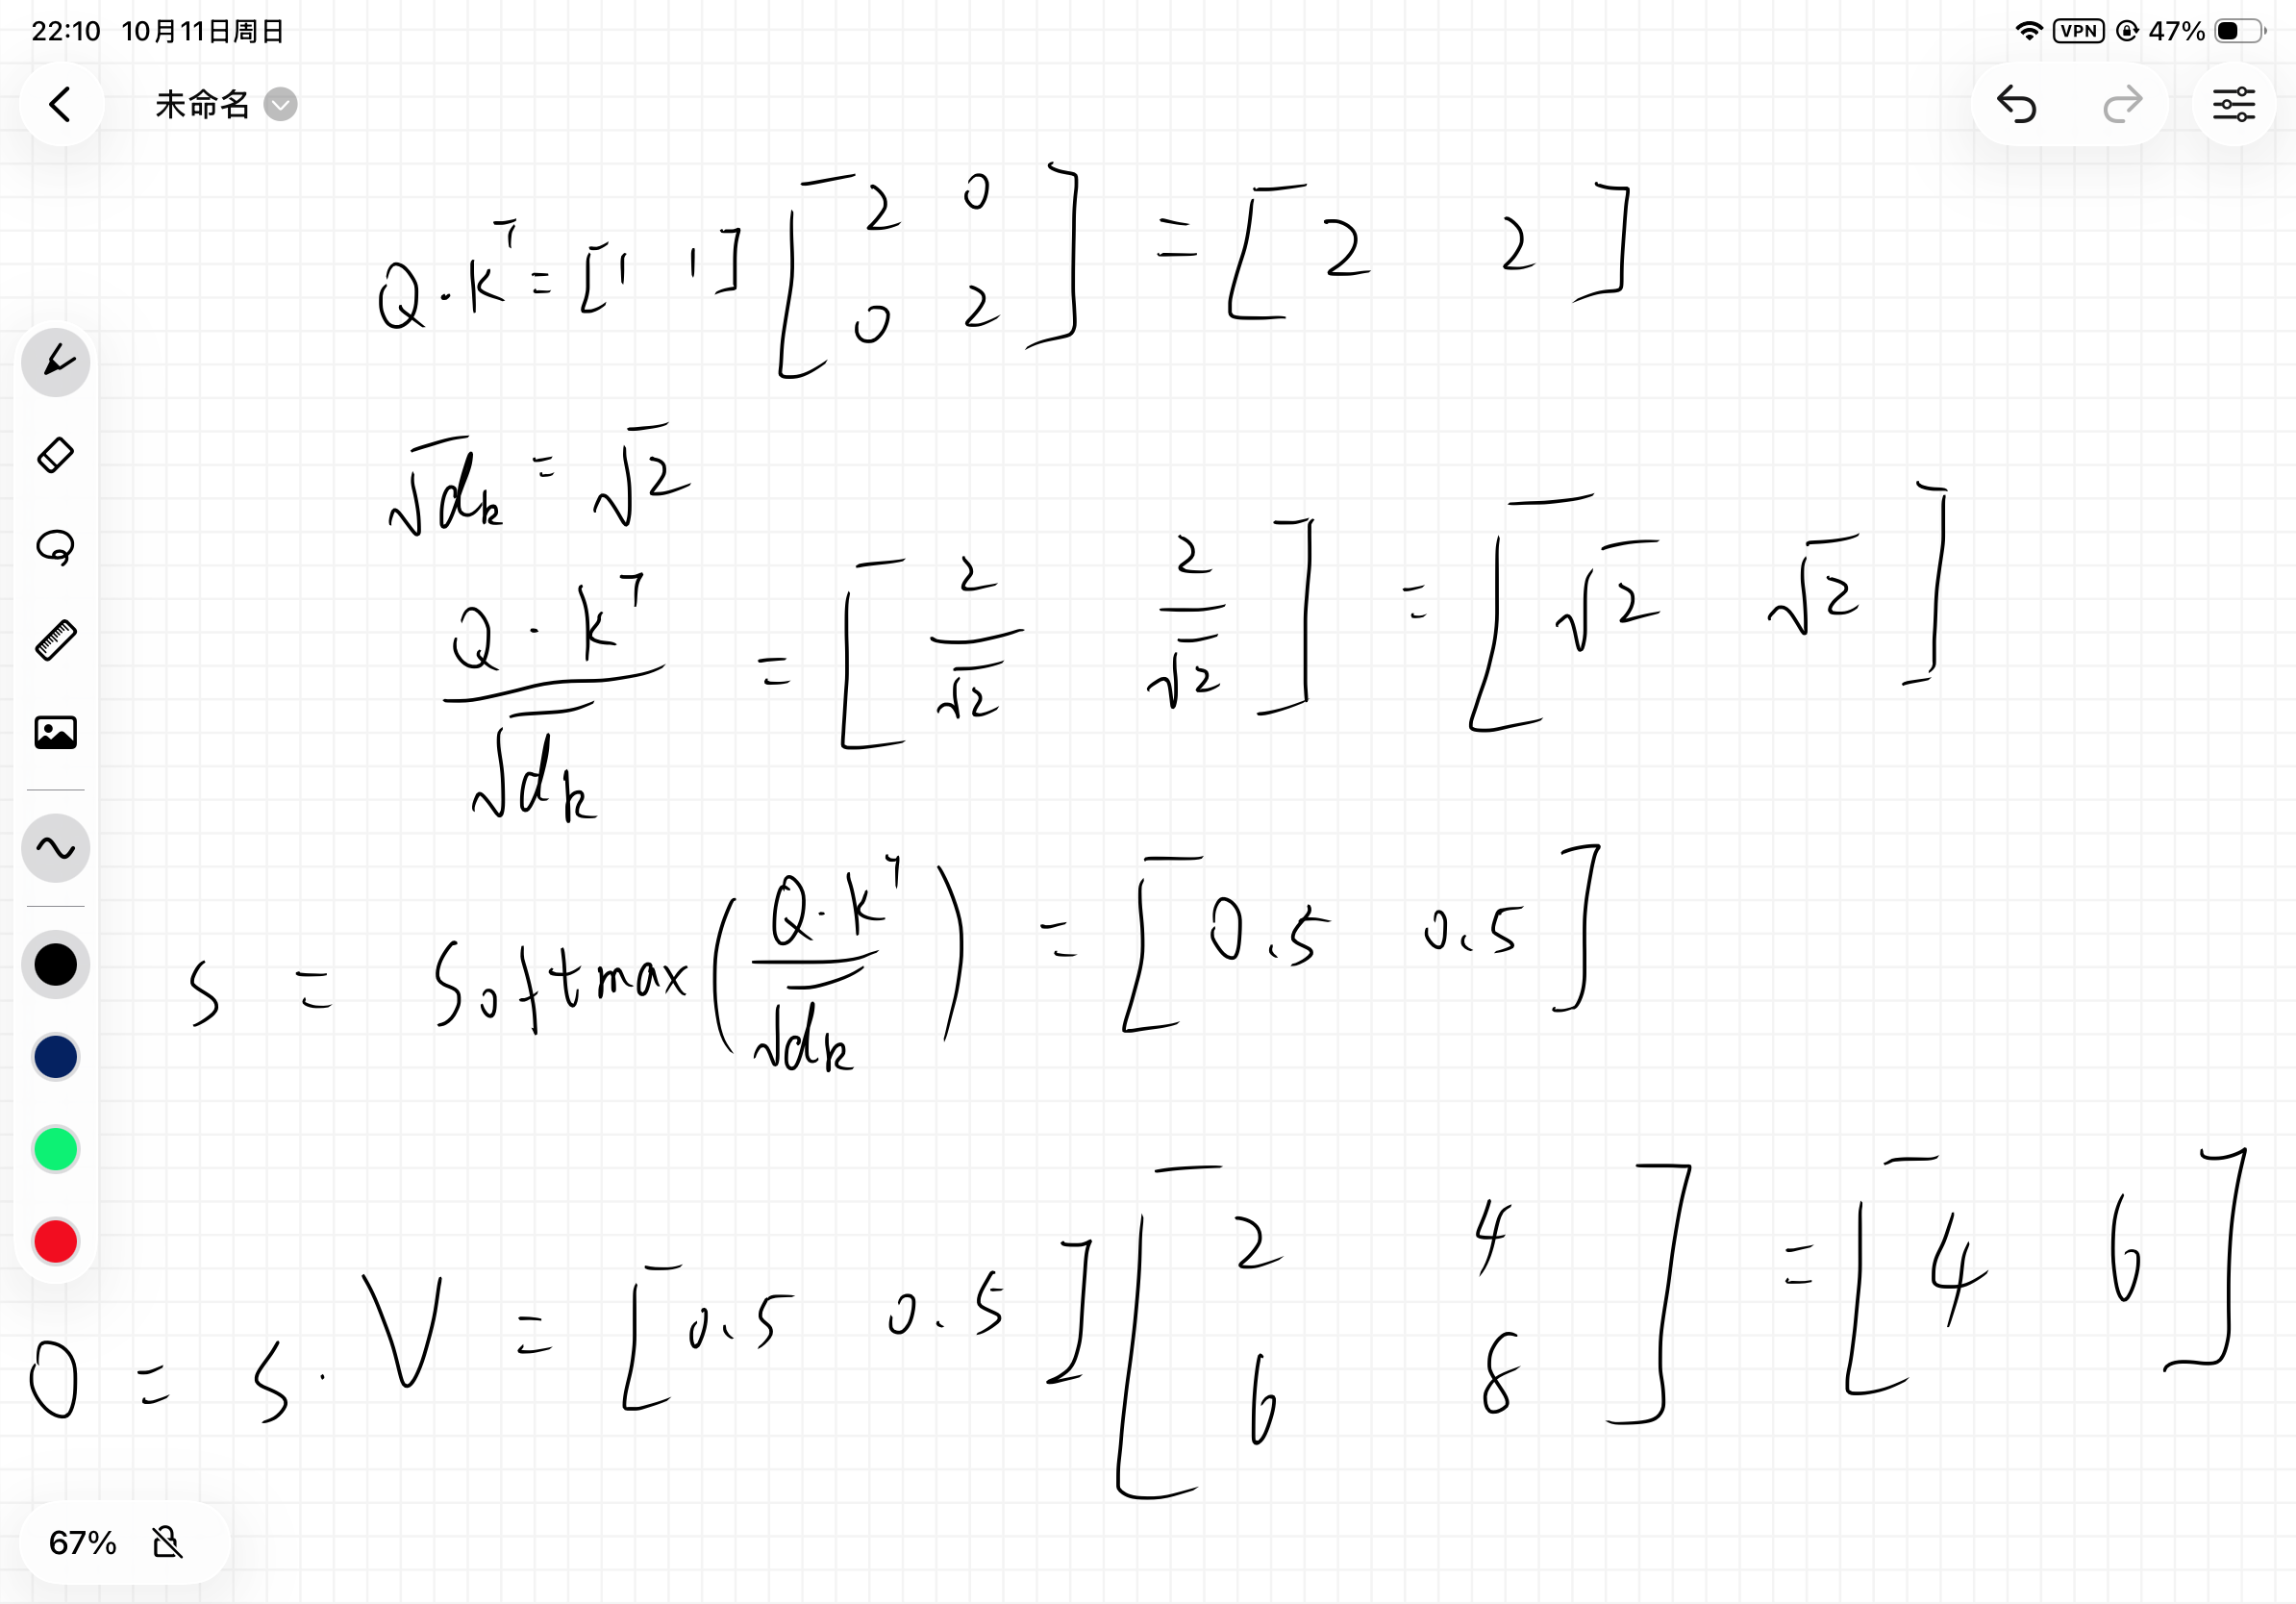
值得纪念!!这是我手算的第一个Attention!
K的转置
为什么只有矩阵K需要转置呢?
就用刚刚的例子:
在标准 Attention 中,每一行代表一个 Token 的向量。 我们希望 Q 分别和 K 的每一行做点积:
但矩阵乘法是行乘列!
所以要把 K 的每一行变成一列:
得到:
这道题的K恰好转置前后形状相同,但是一般情况下不是这样
为什么V不转置呢?
因为 Softmax 已经给我们算出了两个权重:
而 V 的每一行对应一个 Token 提供的信息:
我们希望:
也就是:
矩阵乘法刚好可以:
一句话记忆:K 转置是为了让 Q 逐个匹配 Key;V 不转置是为了让权重逐行汇总 Value。
Self-Attention
现在我们不再只考虑一个 Query,而是让三个 Token 都有自己的 Query。
假设:
那么:
思考题:这个 3\times3 矩阵中,第 2 行、第 3 列的元素代表什么?
我的答案:
第 2 个 Token 对第 3 个 Token 的匹配分数
答对啦!!!
假设我们有三个 Token:
那么:
所以:
- 行代表:谁正在查询?(Query)
- 列代表:正在查询谁?(Key)
- 第 2 行第 3 列:第 2 个 Token 对第 3 个 Token 的匹配分数。
注意,这里还只是原始点积分数,不是 Softmax 后的注意力权重。
Causal Mask
咱们已经知道,每个 Token 都可以用 Self-Attention 获取其他 Token 的信息。
但 GPT 有一个限制:
预测下一个 Token 时,不能偷偷看到未来!
假设输入是:
我 / 喜欢 / 数学
对于 GPT:
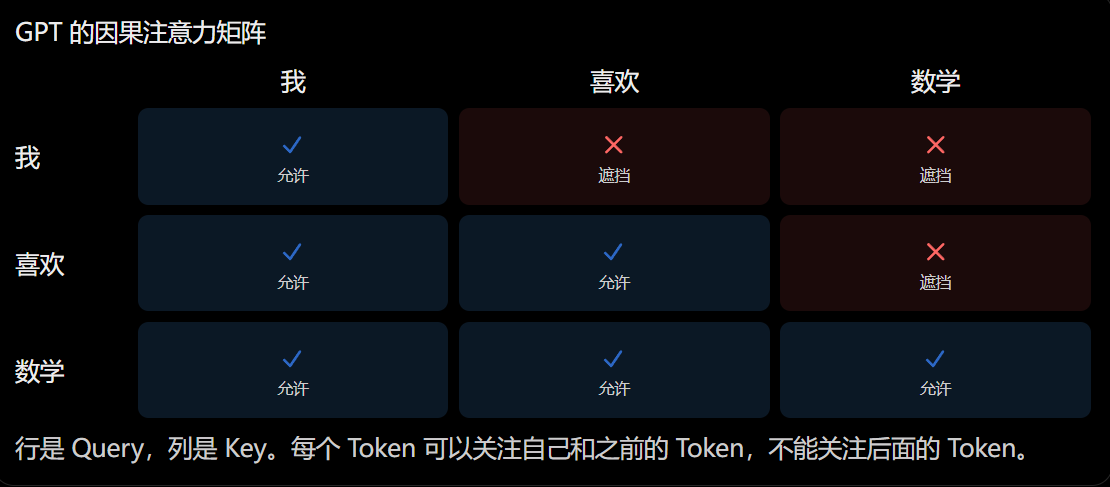
因此,我们需要一个 Mask 矩阵:
在计算 Softmax 之前,把它加到缩放后的匹配分数上:
为什么要加负无穷呢?
咱们之前已经推导过了:
而:
所以被Mask的位置,Softmax之后的权重就变成了0!!
这样,未来 Token 的 Value 就不会参与当前 Token 的加权求和。
所以对于咱们的GPT目标来说,现在更近了一步!
让咱们来写代码吧~
import numpy as np

def self_attention(X, W_Q, W_K, W_V):
    Q = X @ W_Q
    K = X @ W_K
    V = X @ W_V

    # 算维度
    d_k = K.shape[1] #shape[1]表示取列数,在这里是Key矩阵的维度
    scores = (Q @ K.T) / np.sqrt(d_k)

    # Causal Mask
    n = X.shape[0] #shape[0]表示取行数,在这里取得
    mask = np.triu(
        np.ones((n, n), dtype=bool),
        k=1
    ) # 生成上三角遮罩

    scores = np.where(mask, -np.inf, scores) #进行遮罩遮挡

    scores = scores - np.max(
        scores, axis=1, keepdims=True
    ) #减去最大值,详见博客

    exp_scores = np.exp(scores)
    A = exp_scores / np.sum(
        exp_scores, axis=1, keepdims=True
    )

    O = A @ V

    return O,A


# 准备数据
X = np.array([
    [1.0, 0.0],
    [0.0, 1.0],
    [1.0, 1.0]
])

# 教学演示:使用单位矩阵
W_Q = np.eye(2)
W_K = np.eye(2)
W_V = np.eye(2)

O, A = self_attention(X, W_Q, W_K, W_V)

np.set_printoptions(precision=3, suppress=True)

print("注意力权重 A:")
print(A)

print("Self-Attention 输出 O:")
print(O)
输出结果:
注意力权重 A:
[[1.    0.    0.   ]
 [0.33  0.67  0.   ]
 [0.248 0.248 0.503]]
Self-Attention 输出 O:
[[1.    0.   ]
 [0.33  0.67 ]
 [0.752 0.752]]
ok笔记时间!
Q = X @ W_Q
K = X @ W_K
V = X @ W_V
表示输入矩阵和权重QKV矩阵进行矩阵乘法得到QKV矩阵
Note
输入的「列数」必须等于权重矩阵的「行数」!
但是Query特征维度咱们可以自己设计,也就是W_Q的列数
d_k = K.shape[1]
表示取K矩阵的列数,也就是每个K的维度
# Causal Mask
    n = X.shape[0] #shape[0]表示取行数,在这里取得
    mask = np.triu(
        np.ones((n, n), dtype=bool),
        k=1
    ) # 生成上三角遮罩
这段是生成Causal Mask,咱们一层一层拆
np.ones((n, n), dtype=bool)
意思是:生成一个n*n的矩阵,dtype=bool表示矩阵里每个数据都是布尔值,即True 或 False
为什么 Causal Mask 是
n*n的矩阵呢?因为Q和K矩阵的大小完全一样,均为 (n,d_k),n是K的行数,QK^T最终是n*n的矩阵,Causal Mask 需要与注意力分数矩阵逐元素对应,用来屏蔽未来 Token,所以其形状也必须是 (n,n)。
得到:
然后来看
np.triu(..., k=1)
triu 是 triangle upper 的缩写,可以理解为提取矩阵的上三角部分
参数 k 决定从哪条对角线开始保留元素
注意这里是保留元素
0是主对角线,负正表示向左向右偏移对角线
但主对角线也包括当前所研究的token,所以
标准的 GPT Causal Mask 使用 k=1:
但由于np.triu决定了哪些地方被保留,所以咱们后面需要使用:
scores = np.where(mask, -np.inf, scores)
意思是:
如果mask对应位置是True,就改成-np.inf(负无穷),否则就还保持scores本身
Warning
这里要注意!!!要先遮住未来token的注意力分数,否则如果先减去最大值,然后Mask,那么较小的分数在e^x运算的时候在常见浮点数精度下回下溢为0,导致前面的token也无法计算分数
那么为什么
scores = scores - np.max(
        scores, axis=1, keepdims=True
    ) #减去最大值,详见博客
这段代码分为三部分:
np.max:找最大值axis=1沿着列的方向,在每一行内部找最大值。keepdims=True:保留二位形状,方便后续广播减法
最后再用原来的矩阵减去最大值,矩阵中的每个元素都减去这一行的最大值
比如原来:
然后求每一行最大值:
得到:
为什么要这样做呢?
因为 Softmax 对整组分组同时加减一个常数,结果不变:
证明:
咱们给所有的输入减去同一个数c
利用:
有:
同时约掉1/e^c:
证毕
减去最大值能够防止 e^x 过大,导致计算机浮点数溢出。
这叫数值稳定性优化!
exp_scores = np.exp(scores)
np.exp(x)就是计算
它会对矩阵中每个元素分别运算
所以:
要注意
等于0哦
这就是为什么被 Causal Mask 遮挡的 Token 最终权重为 0。
A = exp_scores / np.sum(
    exp_scores, axis=1, keepdims=True
)
实现 Softmax 公式!
np.sum(exp_scores, axis=1, keepdims=True)
axis=1:按行求和keepdims=True:保留二维结构,结果仍然是矩阵
最后咱们就得到了咱们的A矩阵啦~和V做矩阵乘法就得到了最后的O矩阵!!
Self-Attention的反向传播
啧,写到这里我突然发现了一个问题,反向传播肯定需要计算Loss,Loss又要通过正确答案来计算,可是我也不知道正确答案是啥啊!
我还不知道文字怎么变成向量呢!
所以我打算补一个章节
#4.5《从文字到向量:Tokenizer 与 Token Embedding》
等我回来!
2026.10.25
hhhh回来啦~
Attention is all you need – #4.5 Tokenizer 与 Embedding – 99的小站 – 99的小站
快去看看吧~
hhh回到正题,既然是反向传播,那咱们就要从前向传播反着一步一步走回去
前向传播是根据Q,K,V和X计算的,X又来自Embedding矩阵,所以咱们在反向传播需要推导
也就是求出 Embedding、Q、K、V 投影矩阵的参数梯度。
这次咱们先假设:
-
词表大小:6
-
输入 Token 数:n=3
-
Embedding 维度:d_{\text{model}}=4
-
Q、K 向量维度:d_k=2
-
V 向量维度:d_v=2
| 矩阵 | 维度 | 含义 |
|---|---|---|
| E | 6\times4 | Embedding 参数 |
| X | 3\times4 | Token 向量 |
| W_Q,W_K | 4\times2 | Q、K 投影权重 |
| W_V | 4\times2 | V 投影权重 |
| Q,K,V | 3\times2 | 注意力计算输入 |
| S,A | 3\times3 | 注意力分数与权重 |
| O | 3\times2 | Attention 输出 |
从输出O反向传播
我们知道:
假设后面的网络已经传回梯度:
那怎么算 A 和 V 的梯度呢?
矩阵反向传播依然遵循链式法则。但一个元素可能通过多条路径影响 Loss,所以需要把各条路径贡献的梯度相加。矩阵运算可以高效地完成这些计算。
看一个简化版 Attention:
前向传播:
现在我们假设一个教学用的 Loss:
那么上游传回来的梯度就是:
这句话很重要:它表示 O_1 改变一点,对 Loss 的影响系数是 1;O_2 的影响系数是 2。
求 A 的梯度
咱们把矩阵乘法展开:
注意!a_1 同时影响了 O_1 和 O_2。
所以它对 Loss 的影响需要把两条路径加起来:
代入:
同理:
在这个例子中,O_1、O_2 对 a_1、a_2 都是线性函数。求某个变量的偏导时,可以保持其他变量不变,直接取对应的系数。
因此:
转换成公式呢?
已知:
我们希望:
- 第一个梯度是 1\times2+2\times4=10
- 第二个梯度是 1\times6+2\times8=22
也就是说,我们需要让 G_O 分别和 V 的每一行进行点积!
所以转置!
然后:
我去!这不就是刚刚用链式法则算出来的结果嘛!
于是我们得到了:
这就是A的梯度
V的梯度
比如 V_{1,1}=2,它参与的是:
所以:
其他位置同理,最终:
观察一下,它恰好等于:
因此,对于 O=AV,咱们终于得到了两条反向传播公式:
下次,咱们继续研究从G_V推导到G_{W_V}
评论(0)
暂无评论