

Attention Is All You Need #3: 神奇又重要的初始化
欢迎回来~今天作业都写完啦~来学一个小时,不论最开始的99mlp还是上篇博客所修改的矩阵版,都有训练失败的问题,GPT 提出,权重初始化可能是重要原因之一,这篇博客我们就来研究它。
那么,随机初始化权重的数值,有什么问题呢?
随机初始化到底有什么问题?
来看初始化权重W矩阵的代码:
self.W = np.random.randn(neuron_num, weights_num)
GPT说np.random.randn生成的是服从标准正态分布的随机数:
天啊这个\mathcal N(0,1)是啥啊呜呜,快来查查
它的意思是:随机变量 X 服从均值为 0、方差为 1 的正态分布。
咱们拆开看:
- \mathcal N:Normal Distribution,正态分布。
- 0:平均值 \mu=0,随机数主要集中在 0 附近。
- 1:方差 \sigma^2=1,因此标准差 \sigma=1。
- \sim:表示「服从某种分布」。
正态分布又是啥?
正态分布是一种连续概率分布,其概率密度函数呈对称的钟形曲线,广泛用于描述自然和社会现象的数据分布。
人话讲,正态分布,就是一种「中间出现得多,两边出现得少,而且左右对称」的随机数分布规律。
举个例子 🌟
假设我们测量很多人的身高:
- 身高 170cm 左右的人比较多。
- 身高 160cm、180cm 的人相对少一些。
- 身高 140cm、200cm 的人就更少了。
如果这些身高近似服从正态分布,画出来就是一条像小山一样的曲线!
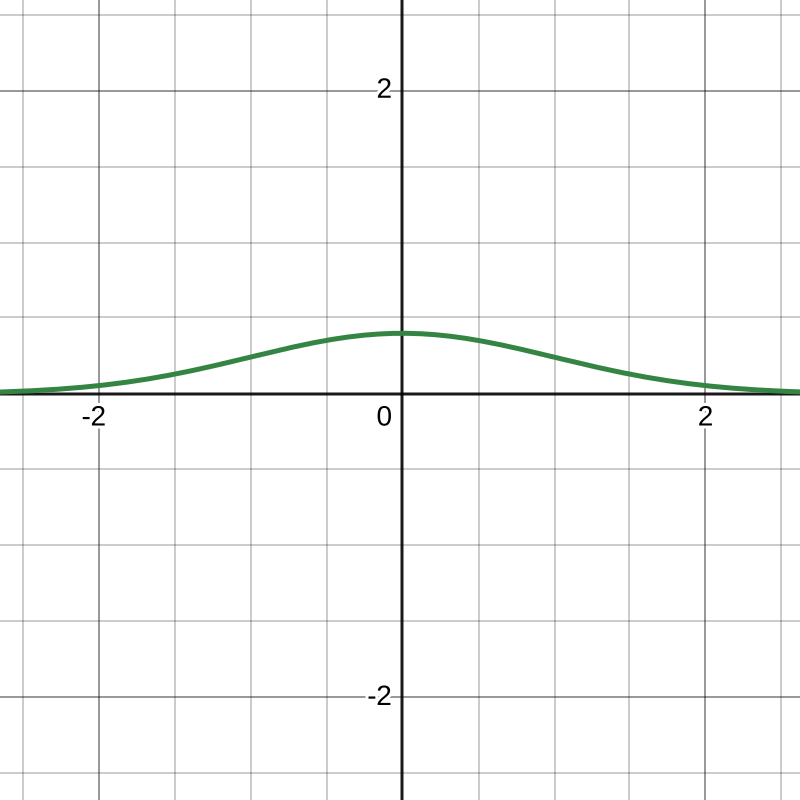
这条曲线叫做正态分布曲线,又叫「钟形曲线」。
标准正态分布函数解析式:
啊,看起来好复杂,不过这个式子现在可以先不理解~只要知道
表示从「均值 0、方差 1」的正态分布中随机取数。就可以啦
问题是,假设将来有一个非常大的神经网络:
Layer(100, 100)
每一个神经元都有100个输入!我嘞个去
按照之前的笔记,一个神经元在经过激活函数之前计算:
假设这100个输入都具有平均数0,方差1,并且相互独立,权重也独立随机初始化
根据方差的性质:
当各项相互独立时成立。
那么我们就能算出:
Var又是啥!?
啊,原来Var就是方差的概率论写法,其实和高中数学里的方差差不多,但是不完全一样
高中数学的方差:
概率论方差:
概率论方差这个公式本质上就是高中的方差公式,只不过把算数平均推广成了按照概率求平均
E[X]是啥?
E 是英文 Expectation(期望)的缩写
意思是:随机变量X的期望值。
举个例子就好懂多啦
假设一个随机变量 X,只有三种可能的结果:
| X 的值 | 出现概率 |
|---|---|
| 1 | 25% |
| 2 | 50% |
| 3 | 25% |
那么:
所以期望其实就是一种加权平均数
而高中的普通平均数:
其实就是相当于每个数据的权重都是\frac1n
X-E[X]
前面已经有了:
所以
它表示随机变量 X 偏移平均值多少
| X | X-E[X] |
|---|---|
| 1 | -1 |
| 2 | 0 |
| 3 | 1 |
诶?这个好像就是高中方差里面的
一模一样的思想!
之后跟高中方差一样,平方
得到了
| X | 偏差 | 偏差平方 | 出现概率 |
|---|---|---|---|
| 1 | -1 | 1 | 25% |
| 2 | 0 | 0 | 50% |
| 3 | 1 | 1 | 25% |
这样,距离平均值越远,平方偏差就越大。
最关键的一步!为什么外面还有个E?
里面的 E[X] 是先求 X 的平均值。
外面的 E[\ ] 则是对偏差平方再求一次加权平均值。
也就跟高中方差最后除以n的作用相同,只不过高中方差的权重都是\frac1n
例题!
如果盒子里有 10 个球,其中 7 个写着数字 1,3 个写着数字 5,每个球被抽中的可能性相同。
那么:
算算看:
好耶!就是这样!
那么这个例子的方差就是:
这就是概率方差和算数方差的区别啦~
再来说说方差的加法性质:
如何推导这个式子呢?
咱们假设
其中A,B是随机变量
根据方差定义:
因为期望具有线性性质:
所以有:
代入:
展开平方:
重点来了!
又因为常数的期望值等于它本身!
所以
因为 A、B 相互独立:
则有:
所以最后:
即:
继续回到刚才的公式:
因为 w_i,x_i 独立、均值均为 0、方差均为 1,所以
也就是说标准差:
哇!每个权重的标准差只有 1,但是加起来之后,z 的标准差居然变成 10 了!
这就可能导致两个问题:
- 前向传播时,数值的尺度随着网络层数发生明显变化。
- 反向传播时,梯度可能越来越大或越来越小。
为什么会导致这两个问题呢?
咱们要抓住一个非常重要的事实:
第一层放大的数值,不会凭空消失,而是会继续进入第二层。
先考虑一个没有激活函数的简化网络,每个神经元都有 100 个输入,权重独立、均值为 0、方差为 1。
| 层数 | 激活前输出方差 | 标准差 |
|---|---|---|
| 第一层 | 100 | 10 |
| 第二层 | 10,000 | 100 |
| 第三层 | 1,000,000 | 1,000 |
为什么会这样呢?
因为第一层
第二层接收的是第一层的输出 z_1。由于第一层输出的方差已经变成 100,因此第二层的输入方差也是 100。
第三层继续乘:
这个数字增长的速度简直就是爆炸式增长
而且网络越深,数值尺度就可能增长得越夸张。
当然,这个表是没有激活函数的简化推导。现有的 ReLU 网络并不会严格按照这个表增长,但在这些随机初始化假设下,信号的平方均值仍可能每层约放大 50 倍。
当数值越来越大时,训练中的激活值、损失值以及某些计算结果就可能变得非常大,造成数值不稳定。
为什么梯度也会越来越大或者越来越小呢?
先考虑最简单的一个神经元且忽略激活函数:
假设损失函数是 L。
根据链式法则:
发现了吗?
梯度反向传递的时候,会向上乘以权重!
假如连续三层的权重都是2,那么反向传播的梯度到最后就是8
假如都是0.5,那梯度传到最后就是0.125
所以即使有激活函数,反向传播也会进行反复乘法运算,梯度的尺度就有可能发生剧烈变化,尤其是 Sigmoid,如果输入特别大或者特别小,就很容易进入导数接近零的饱和区域。
因此,我们需要根据每个神经元接收的输入数量,合理控制初始权重的大小,从而降低前向信号和反向梯度过度放大或缩小的风险。
fan_in、fan_out
fan_in 就是一个神经元接收的输入连接数量。
fan_out就是一个这一层有多少输出神经元
GPT的小测试~
假设我们使用 Leaky ReLU,下面有两个神经网络层:
A 层
100 × 2
Layer(100, 2)
B 层
2 × 100
Layer(2, 100)
为了避免前向传播数值过大,你觉得哪一层应该初始化得更小?
-
A 层,因为它有 100 个神经元
-
B 层,因为每个神经元有 100 个输入
-
一样大,因为权重矩阵的元素总数相同
选B!
B 层需要更小的权重,是因为每个神经元要把 100 个加权输入相加,容易让输出数值的尺度变大。
那么合适的初始化方法到底解决了什么问题呢?
由于多个输入在与权重相乘并求和之后,每一层输出数值的尺度可能会爆炸式增长或衰减,所以咱们需要一种方法
让神经网络每经过一层,输出的数值尺度都尽量保持稳定。
该怎么做呢?
之前咱们推导过:
当输入均值为 0、方差为 1,各项独立,权重也独立且均值为 0 时:
现在咱们希望这一层输出的方差也等于1
所以可以:
也就是:
哇!这样一来,无论有多少个输入,我们都可以通过调整权重方差,避免这一层把输入的方差放大!
但是有个问题……
He 初始化
ReLU把所有的负数都变成了0!
咱们现在的初始化代码:
self.W = np.random.randn(neuron_num, weights_num)
生成服从均值为0,方差为1的正态分布
也就是以0为平均数,左右对称,越靠近 0,概率密度越高,离 0 越远,出现的可能性通常越小。
根据正态分布的性质,独立正态随机变量乘以常数后再相加,仍然服从正态分布。
由于我们初始化的权重均值为 0,假设输入值固定、权重相互独立且偏置为 0,那么加权求和后的 z 仍然服从均值为 0 的正态分布。
因此,z 的概率分布关于 0 对称。
假设:
那么:
因为 z 的分布关于 0 对称,正数和负数对 E[z^2] 的贡献相等。
而经过 ReLU 后,负数部分的平方全部变成 0。
所以:
这里减半的是平方的期望,不是严格意义上的方差
因为经过 ReLU 后,输出的平均值通常不再是 0。
现在咱们把两部分合起来!
这次我们研究的是整个网络中连续的两层,而不只是第一个神经元。
设上一层激活值为 a_i,下一层的线性计算为:
假设权重独立、均值为 0,且与输入独立。为了简化推导,偏置设为 0。
所以:
假如n=2
利用完全平方公式:
根据期望的性质,当两个随机变量相互独立时,期望可以拆开相加。
得到:
因为咱们初始化权重的正态分布均值是0
所以各个权重的期望也是0
根据期望的性质,当两个随机变量相互独立时,它们乘积的期望等于各自期望的乘积:
因为咱们假设各个权重相互独立,并且与输入值相互独立:
所以:
所以最后的式子就等于
回到n个权重与输入,公式就是:
乘法性质:
所以:
由于权重均值为0:
如果各输入激活值的平方期望相同,为了方便书写,我们用 q 表示它们共同的平方期望,也就是q=E[a_i^2],那么:
这就是咱们的这个公式啦~
-
n:输入数量,即
fan_in。 -
\operatorname{Var}(w):权重的方差。
-
q=E[a_i^2]:上一层激活值平方的期望。
-
E[z^2]:当前神经元激活前输出平方的期望。
再经过ReLU
现在就有了前一层激活输出和后一层激活输出的关系方程啦
咱们的目标是让两层激活值的平方均值尽量保持不变,所以令:
所以
最后对于w_i的概率论方差就是
推出来啦!这就是He初始化的核心推导!
只需要让权重初始化数值在随机的时候保持方差为\frac2n就可以啦
代码中,咱们可以使用numpy的指定正态分布均值与标准差函数:
np.random.normal(loc, scale, size)
| 参数 | 意思 |
|---|---|
loc |
均值 \mu |
scale |
标准差 \sigma |
size |
生成数组的形状 |
比如:
np.random.normal(0, 2, (3, 4))
表示生成一个 3×4 的矩阵,每个元素独立地从下面的正态分布中抽取:
注意这里传入的是标准差!也就是方差开根号
所以咱们原来的初始化改成:
self.W = np.random.normal(0,math.sqrt(2/weights_num), (neuron_num, weights_num))
连续训练五次的结果!!
[[0.05000393]]
[[0.98421973]]
[[0.98381852]]
[[0.05004344]]

[[0.0732803]]
[[0.98319848]]
[[0.98253261]]
[[0.03048717]]

[[0.02912275]]
[[0.99501697]]
[[0.99452799]]
[[0.0291227]]

[[0.0064221]]
[[0.99681663]]
[[0.99108292]]
[[0.0064221]]

[[0.03073486]]
[[0.99494596]]
[[0.99540396]]
[[0.03073544]]
全成功了!有点东西!!
做个小实验吧,我用原来的方差为1均值为0的正态分布随机训练100次看效果,再用He初始化训练100次,来看看成功率,一次成功是指四个 XOR 样本在阈值 0.5 下是否全部分类正确。
激动人心的结果!!
xychart-beta
    title "令人伤心的失败结果"
    x-axis ["默认0均值1方差正态分布","有问题的He初始化"]
    y-axis "训练成功率 (%)" 0 --> 100
    bar [46,45]
不。。。这不可能!!!!
*晕倒
啊好吧其实是可能的,GPT指出了两点,第一,99mlp的隐藏层用的是Leaky ReLU啊!!!
这里用\alpha表示LeakyReLU负数部分的斜率
所以之前推导的激活输出平方的期望就是
带入前面算出的E[z^2]
现在让上一层激活输出平方期望等于下一层激活输出平方期望,约掉
LeakyReLU公式:
但是99mlp中LeakyReLU的\alpha值设置的是0.01啊,经过平方后影响已经微乎其微了,问题出在哪里了呢?
我突然注意到,He初始化只是给ReLU及类ReLU准备的,但是输出层使用了Sigmoid,Sigmoid不适合用He来初始化
对于Sigmoid激活函数,可以使用Xavier初始化
Xavier初始化
He初始化重点考虑怎样让前向传播时的信号平方均值尽量保持稳定。
而Xavier 初始化的思路是:既然要保持前向传播稳定,那为什么不同时考虑反向传播的梯度呢?
先推导前向传播需要什么
为了简化数学,咱们暂时研究不带激活函数的线性层,假设权重独立、均值为 0,输入的平方均值相同,并且权重与输入独立。
根据之前的推导:
咱们希望前向传播的平方均值保持不变:
于是:
所以:
这就是前向传播希望得到的权重方差!
那反向传播呢?
现在假设某层有 3 个输出神经元,某个输入神经元与它们全部相连。
反向传播时,这个输入对应的梯度就会收到来自 3 个输出方向的贡献:
诶?这个跟
长得好像!但是因为是反向传播,所以
也就是
然后咱们希望后一层的梯度到了前一层平方均值保持不变
所以
嘶。。。。。诶但是这不太好,如果fan_in和fan_out不一样的话,权重方差没法求了!
所以Xavier 初始化采取了一种折中方案
把两个连接数取算术平均:
然后按照前面推导的思路,让:
于是:
这就是 Xavier 正态初始化 的经典公式!
GPT说还有一个值得写到笔记里的东西!
Xavier Uniform – 均匀分布初始化
Xavier Uniform 不使用正态分布,而是使用均匀分布!
Xavier Uniform希望权重服从:
其中 U 表示均匀分布。
对于这种分布,有一个方差公式:
而我们之前推导的 Xavier 初始化要求:
所以让两个方差相等:
化简得:
于是 Xavier Uniform 就可以这样实现:
a = math.sqrt(6 / (weights_num + neuron_num))

self.W = np.random.uniform(
    -a,
    a,
    (neuron_num, weights_num)
)
来改代码!!!
首先给初始化改成LeakyReLU的He初始化和Xavier初始化
def __init__(self, neuron_num, weights_num, activation="relu"):
    # 初始化神经元矩阵,random.randn是生成行x列的矩阵,里面的数值随机
    # 因为每个输入要和每个权重点乘,又因为矩阵乘法是行点乘列,所以每个神经元的每个权重存在矩阵的行中
    # 然后每行里的每个权重就可以和输入(看做多行1列的矩阵)点乘啦~
    # self.W = np.random.randn(neuron_num, weights_num)
    # self.W = np.random.normal(0,math.sqrt(2/weights_num), (neuron_num, weights_num))

    if activation == "sigmoid": # 使用Xavier初始化权重
        self.W = np.random.normal(0, math.sqrt(2/(weights_num+neuron_num)), (neuron_num, weights_num))
    else: #使用LeakyReLU的He初始化
        self.W = np.random.normal(0, math.sqrt(2/((1+0.01*0.01)*weights_num)), (neuron_num, weights_num))

    # 创建一个neuron_num行,1列的矩阵,也就是咱们的偏置矩阵!
    # 偏置矩阵都填充0就好,偏置初始值设置为0更高效
    self.b = np.zeros((neuron_num,1))
    self.activation = activation #激活函数可以设定模式了
来看100次输出实验结果:
xychart-beta
    title "令人更伤心的失败结果"
    x-axis ["默认0均值1方差正态分布","有问题的He初始化","使用了LeakyReLU和Xavier初始化后"]
    y-axis "训练成功率 (%)" 0 --> 100
    bar [46,45,44]
没有观察到明显差异甚至往下跌了!?
*睡着了
GPT提出将训练样本的顺序打乱
可以用numpy的random.permutation()来做到这一效果
np.random.permutation(len(train_data))
因为train_data有四个对象,所以最终传给该函数的值为4
numpy会生成一个由0、1、2、3组成的随机排列
不会重复,也不会遗漏
所以放到for循环当中,顺序就被打乱啦~
来试试看
for epoch in range(20000):
    for simple in np.random.permutation(len(train_data)):
        y = train_data[simple][2]
        haty = network.forward([train_data[simple][0],train_data[simple][1]])
        # 因为forward最后返回的是每个神经元的输出,然后最后一层就一个神经元,所以用[0]
        dL_dhaty = 2*(haty[0] - y)
        network.backward(dL_dhaty,0.01)
来看结果吧~
xychart-beta
    title "令人开心的实验结果"
    x-axis ["默认0均值1方差正态分布","有问题的He初始化","换用初始化","打乱顺序后"]
    y-axis "训练成功率 (%)" 0 --> 100
    bar [46,45,44,55]
好耶!!!终于涨啦!!!
原本以为,经过一下午的数学推导,使用 He 和 Xavier 初始化后,99MLP 的训练成功率会显著提高。
然而实验结果却出乎意料:46%、45%、44%……成功率不仅没有提高,反而略有下降。
直到我尝试随机打乱训练数据的顺序,成功率才在这组实验中提高到了 55%。
看来,权重初始化只是影响神经网络训练的因素之一。既然训练顺序能够影响最终结果,那么 Loss 呢?
下一篇,我们就来研究它。
继续加油!!!
评论(0)
暂无评论