

Attention Is All You Need – #1:重拾神经网络
写在前面
今天又看了一遍Claude Opus 5.5生成的MV,真的超级震撼,也觉得我也是时候该看看那神秘已久的Transformer到底是个啥了,这个系列的博客我会持续更新,这是我个人的学习笔记,不完全正确!,这不是教程,而是个人的笔记,如有问题欢迎莅临指导!
本次的学习旅程由GPT大人带领
神经元 – Neuron
神经元 = 把几个输入按不同重要程度加起来,再经过一个函数,得到一个输出。
数学上的核心:
然后
参数的意义:
-
x_i:输入
-
w_i:权重,表示“这个输入有多重要”
-
b:偏置,可以理解成“整体往上/往下挪一点”,让神经元不止能学习过原点的数据
-
f:激活函数
-
y:神经元最终输出
神经元“学习”的东西,主要就是这些 w 和 b。
一个人工神经元接收多个输入 x, 每个输入乘以对应权重 w, 将结果求和后加上偏置 b, 最后经过激活函数,得到输出。
一个数学核心神经元:
class Neuron():
    def __init__(self, weights, bias):
        self.weights = weights
        self.bias = bias

    def forward(self, inputs):
        sigma = 0
        for x, w in zip(inputs, self.weights):
            sigma += x * w
        sigma += self.bias
        return sigma
激活函数
GPT说现在的这个神经元还缺激活函数,我看看怎么个事
激活函数干啥用的
激活函数最核心的作用就一句话:
给神经网络加入“非线性”。
不然堆再多层神经元,最后本质上还是一个大号线性函数(GPT纠正说是线性/仿射变换)。
GPT推荐我学习的第一个激活函数是ReLU,但是我第一次学习的时候给我推荐的sigmoid
ReLU长这个样子
输入负数 -> 输出 0
输入正数 -> 原样输出
sigmoid和ReLU
Sigmoid:平滑、输出 (0,1),但容易饱和。 ReLU:简单、训练方便,常用于隐藏层。
GPT说Sigmoid常用于二分类输出层,ReLU常用于隐藏层,因为Sigmoid容易梯度消失
升级神经元!
class Neuron():
    def __init__(self, weights, bias):
        self.weights = weights
        self.bias = bias

    def ReLU(self, x):
        return max(0, x)

    def forward(self, inputs):
        z = 0
        for x, w in zip(inputs, self.weights):
            z += x * w
        z += self.bias

        return self.ReLU(z)
神经元层 – Layer
一个 Layer 本质上就是:
很多个 Neuron 并排放在一起,然后把同一份输入分别喂给每个神经元。
代码!
class Layer():
    def __init__(self, neurons):
        self.neurons = neurons

    def forward(self, inputs):
        neurons_output = []
        for neuron in self.neurons:
            neurons_output.append(neuron.forward(inputs))

        return neurons_output
同一份 inputs → 喂给这一层的每个神经元 → 收集每个输出 → 返回列表。
神经网络 – Network
神经网络就是让数据能穿过每一层
class Network():
    def __init__(self, layers):
        self.layers = layers

    def forward(self, inputs):
        layers_output = inputs
        for layer in self.layers:
            layers_output = layer.forward(layers_output)

        return layers_output
让神经元学习
Loss – 错了多少
现在的这个神经网络只是一个框架,想让机器学习,得让神经元能被训练
神经网络训练的原理是让网络先猜,然后看它错了多少,再根据“错的方向”一点点修改权重和偏置。
所以现在必须具备知道错误和一步一步往回走,修改错误的能力
前向传播 → 计算损失 → 反向传播 → 更新参数
训练其实就是不断问:
“如果我把这个权重稍微调大一点,Loss 会变大还是变小?”
“如果我把那个 bias 调小一点,Loss 会怎样?”
某个参数变化时 Loss 怎么变化,可以用对应的偏导数描述。把所有参数对应的偏导数组合起来,就得到梯度。
GPT举的这个偏导数的例子,我去没见过的符号
它读作:
“L 对 w 的偏导数”
这个公式表示
权重 w 发生变化时,损失 L 的变化速度和方向。
人话就是w 动一点时,Loss 会往哪个方向变、变得有多快。
我的妈呀这是啥东西,说是偏导数
导数(Derivative)是描述函数在某一点的变化率的数学工具。具体来说,设有函数 y=f(x),在某一点 x0 处,导数的定义为:
就是变化量趋近于0的时候的斜率,自变量变化量趋近于 0 时,函数平均变化率的极限;几何上就是曲线在该点切线的斜率
两个点越来越近,割线最后贴成了切线;割线斜率的极限,就是导数。
(割线就是曲线上的两个点连线)
还有这个长得像6的,我查查
那个长得像6的东西
\partial叫偏导符号
在偏导数里,除了目标变量,其他的变量被当成常数来看
GPT大人的例子:
假设你站在一个山坡上,高度:
H(x,y)取决于你东西方向的位置 x 和南北方向的位置 y。
那么:
\frac{\partial H}{\partial x}表示:
我只往东西方向走,坡有多陡。
而:
\frac{\partial H}{\partial y}表示:
我只往南北方向走,坡有多陡。
你站的位置没变,但两个方向的坡度可能完全不一样。
这就是偏导数。
偏导数本质上仍然是导数,只是专门处理多变量函数。
Gradient – 梯度
现在可以说回到梯度啦
假设一个神经元有两个权重和一个偏置:
我们分别算:
然后把它们装在一起:
这个:
就叫 梯度 gradient。
梯度本质上是一个向量,它指向多元函数值增加最快的方向,并且其大小表示变化率的快慢。
我才明白,梯度的每个分量表示你只沿着这个分量表示的权重再走一点以后,Loss会往哪里变,变得快慢,数字越大越快。
比如一个分量是正数,就说明在当前点附近,这个权重增大一点,Loss 也会增大;权重减小一点,Loss 则会减小。梯度分量的绝对值越大,说明 Loss 对这个权重的变化越敏感
如果是负数呢,就说明在当前点附近,这个权重增大一点,Loss 反而会减小;权重减小一点,Loss 则会增大。同样,梯度分量的绝对值越大,说明 Loss 对这个权重的变化越敏感
为什么是当前点附近呢,因为导数描绘的是极限,是在当前这个地方,斜率或者变化率的情况,如果走远了就不一定是这样了
GPT的比喻:
梯度是 Loss 对所有参数的“变化方向说明书”。
梯度下降,就是沿着 Loss 增长最快方向的反方向调整参数。
GPT问我如何表示错了多少,我回答
GPT说这样会出现负数,而且样本会相互抵消,所以常见的做法是平方
这样还好求导,可以算偏导数了
GPT让我自己写一下偏导数真正长什么样,我写了
她给我展开:
如果 \hat y>y,那么 \frac{\partial L}{\partial\hat y}>0,沿负梯度方向会让预测值 \hat y 倾向于减小 如果 \hat y<y,那么该偏导为负,沿负梯度方向会让预测值 \hat y 倾向于增大
这个Loss公式叫平方误差
拿预测值 \hat y 和正确答案 y 比较,然后给“错得有多严重”打一个分。
Chain Rule- 链式法则
这里暂时忽略激活函数
GPT举了个最简单的神经元例子
它的Loss为
现在想知道w动一点,Loss会怎么变
也就是偏导数
但是Loss 并不是直接由 w 算出来的,而是 w 先影响预测值 \hat y,再由 \hat y 影响 Loss,所以要写两部分
先算出w和帽子符号y的,因为w变了算出的帽子符号y才变,所以y在上头
再算一个帽子符号y和L的
最后乘在一起
这就是链式法则
在前面的笔记里已经算过
然后神经元式子:
在偏导数里,咱们的目标是w,所以x和b都先变成常数,又因为是一次函数,所以w的斜率就是x
那么对于帽子y的偏导数就是
所以:
同理,对偏置来讲,因为是1次函数,不管在哪里斜率都是k,又因为w和x变成常数了,b系数是1,所以
所以对偏置的梯度就是
权重和偏置的梯度都会算了,但是GPT说咱们的激活函数也需要导数,因为反向传播要知道前面这个量动后面跟着动多少,激活函数作为传播过程中的一员,肯定也需要导数
ReLU的导数很直观,因为ReLU这个函数本质上是
所以当x<0的时候导数为0,x>0的时候导数为1
至于 x=0,严格数学上那里有个折角,导数不存在;实际神经网络实现里一般直接约定成 0 或其他固定值。
对于我之前写的神经元代码,神经元在激活函数前产生的结果叫z,所以现在这个简单神经元就是
而通过激活函数后的结果叫帽子y,真正正确的答案叫y
所以要求 Loss 对权重 w 的梯度,就要根据链式法则,把这条路径上各部分的导数乘起来:
其中
就是激活函数的导数
关于Dead ReLU
不难看出z<0 时,梯度确实直接被乘成 0,因为ReLU的导数为0
那为什么还要用ReLU呢?
关键在于在 z>0 的一整片区域,ReLU 的导数永远是 1,这确保了在ReLU的正区域,梯度经过 ReLU 这一环时不会被 ReLU 缩小,因为此时它的导数为 1,乘1怎么会变呢
之后还有人搞出了Leaky ReLU
当输入为负数时,不让 ReLU 的输出直接变成 0,而是保留一个很小的负斜率。
Backpropagation – 反向传播
今天的第一个目标!让99神经网络(雾)学会AND!OR!XOR!
既然要学AND,得先准备训练材料
AND就是两个输入都是1的时候,输出1,其他全是零蛋,训练材料很简单:
| x_1 | x_2 | 正确答案 y |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 0 |
| 1 | 0 | 0 |
| 1 | 1 | 1 |
神经元变成:
经过ReLU:
然后平方得到Loss:
意义小笔记:
何为反向传播
反向传播就是反过来问:
Loss 为什么这么大?
想知道这个,就问:
\hat{y} 动一点,Loss 会怎么变?
再问:
z 动一点,\hat{y} 会怎么变?
再问:
w_1 动一点,z 会怎么变?
反向传播就是在倒着计算每一层的变化率
两个参数,一个一个来,先求 w_1 的梯度:
它正向运算的时候经过了:
所以根据链式法则:
这其实特别像:
w_1 对 z 产生多少影响 × z 对 \hat y 产生多少影响 × \hat y 对 Loss 产生多少影响
一路乘起来:
w_1 最终对 Loss 产生多少影响。
这就是链式法则在神经网络里的核心意义
一个一个算呗
Loss对\hat{y}的导数,前面算过了:
按照咱们的训练材料,假设y=1,但是神经网络猜y=0.6
那么
偏导数为负的意味着当前位置,如果\hat{y}变小,Loss变大
继续求ReLU的导数
前面也说过了,他的导数就是
为了方便,可以写成
所以
最后求z 对 w_1 的导数
神经元公式:
要求的偏导数:
所以把除了w_1的变量全看成常数,式子也就变成了以w_1为自变量的一次函数,一次函数求导结果为斜率,所以:
!!!在这里GPT跟我说,如果
那么
表示如果 w_1 增加0.1, 那 z 也增加0.1
但是如果
那么
也就意味着 w_1 怎么变,z 都不会变,也就是说明这一条训练数据不会修改 w_1
这个很重要
最后超级拼装:
这就是 w_1 的梯度
w_2 同理:
所以:
注意到雷霆规律,权重梯度公式:
有几个输入就有几个 w_i
偏置怎么算?
神经元公式:
咱们先求
除了b,都当成常数
那么
所以最后:
完整梯度:
对于:
我们有:
这三个数就是反向传播算出来的东西
Gradient Descent – 梯度下降
要让神经元真正学习,肯定需要修改权重啦
之前咱们说到,权重越按照梯度的方向变化,Loss就越来越大
但是咱们需要让Loss变小,因为Loss由误差计算而来
所以咱们要反其道而行之,按照梯度相反的方向走,也就是做减法
梯度下降:
其中:
就是learning rate,学习率
学习率是训练者指定的
它的大小判断方法很直观:
- Loss 稳定下降:说明这个学习率大概率还行
- Loss 一会儿大一会儿小,疯狂震荡:学习率太大,比如
0.1可能就迈过头了 - Loss 降得特别特别慢:学习率可能太小,比如
0.000001 - Loss 直接爆炸、变成巨大数字甚至 NaN:通常也是学习率过大
假设:
那么:
手算一遍!
GPT说:咱们现在不写一行代码!你给我手算!
然后给出神经元初始参数:
学习率0.1
现在喂进去 AND 的这一条数据:
正确答案:
用数学自己按照下面这个顺序算: 1. 算
- 算
- 算
- 算
- 判断
是多少 6. 算
- 最后算:
- 再更新:
开始算!!!
好耶!!算出来啦!
接下来就可以给python代码里的神经元写backward()啦~
class Neuron():
    def __init__(self, weights, bias):
        self.weights = weights
        self.bias = bias

    def ReLU(self, x):
        return max(0, x)

    def forward(self, inputs):
        self.inputs = inputs #保存输入,backward时还得用
        z = 0
        for x, w in zip(inputs, self.weights):
            z += x * w
        z += self.bias

        self.z = z #保存z
        self.haty = self.ReLU(z) # 保存haty

        return self.haty

    def ReLU_derivative(self, z):
        if z > 0:
            return 1
        else:
            return 0

    def backward(self, y, learning_rate):
        # 需要真正的结果y,还有学习率eta
        dL_dhaty = 2*(self.haty-y)
        dhaty_dz = self.ReLU_derivative(self.z)
        dL_dz = dL_dhaty * dhaty_dz

        #更新权重
        for i in range(len(self.weights)):
            dz_dwi = self.inputs[i]
            dL_dw = dL_dz * dz_dwi

            self.weights[i] -= learning_rate * dL_dw

        #更新偏置
        dz_db = 1
        dL_db = dL_dz * dz_db

        self.bias -= learning_rate * dL_db
这就是单个神经元的backward()
跑一个训练试试看!
neuron = Neuron([0.5,0.5],0.5) #实例化一个神经元~然后给所有权重给一个初始值,就设为0.5吧
train_data = [
    (1,1,1),
    (0,1,0),
    (1,0,0),
    (0,0,0)
]

for epoch in range(30000):
    for sample in range(4):
        neuron.forward([train_data[sample][0],train_data[sample][1]])
        neuron.backward(train_data[sample][2], 0.01)

for sample in range(4):
    print(neuron.forward([train_data[sample][0],train_data[sample][1]]))
输出结果:
python -u "j:\99的博客\AttentionIsAllYouNeed\MLP.py"
0.999999999999992
2.6645352591003757e-15
2.6645352591003757e-15
0
成功了!!!单个神经元训练成功!!!*开花
但是如果扩大到一层神经元的范围呢
一层当中每一个神经元都有自己的权重,相对应的,一个输入 x_i 会同时连到这一层里的多个神经元
所以反向传播时,这些神经元传回来的梯度要加起来。
假设这一层有三个神经元:
每个神经元都有自己的一套权重,对应输入
来看现在尚未修改的Layer类的代码
class Layer():
    def __init__(self, neurons):
        self.neurons = neurons

    def forward(self, inputs):
        neurons_output = []
        for neuron in self.neurons:
            neurons_output.append(neuron.forward(inputs))

        return neurons_output
把输入分别传入一层当中的所有神经元,并且获得每一个神经元的输出
既然一层不止一个神经元,那Layer收到的自然也就不只有一个梯度
那当反向传播的时候,只需要分别告诉这一层的每个神经元:
Loss 对这个神经元输出的梯度是多少。
假设这一层三个神经元的输出分别为:
从后面传回来的应该是一组梯度:
每个神经元收到梯度以后,算法跟单个神经元的backward()算法是一样的
只不过从
变成
因为这一组里的每个梯度并不是直接从最终结果 \hat{y} 得到的,而是从前面一层的神经元得到的梯度,因为链式效应是乘法,所以在这里替换没有问题
神经元经过backward()之后,成功修改了自己的权重,好耶!
但是问题来了,它怎么把自己的梯度给上一层呢?他怎么跟上一层说,他们的输出对最终的Loss有多大影响呢?
顺水推舟写到Network
既然有多层了,每个层的分工也就变得不同
最一开始接受输入的层叫输入层
最后输出东西给人类看的,叫输出层
中间的神经元层叫隐藏层
问题来了:
x_1 影响了几个神经元?
三个!
因为正向运算时 x_1 同时给三个神经元传入了输入,所以 x_1 自然通过三条路影响最终Loss
于是 Loss 对 x_1 的总影响必须把三条路加起来:
全部加起来
每一条路径怎么算呢?
对于一层的单个神经元,参数到权重到Loss的路径如下(用示例层的第一个神经元举例子):
注意这里的 x_1 是上一层的输出分发给每个神经元,变成这一层每个神经元的输入的
那么反向传播时,这一层的输入,就是上一层的输出,所以backward要返回Loss对这一层每个输入的梯度,也就相当于上一层每个神经元输出的梯度
所以对应的偏导数:
而:
所以:
因此:
其他的神经元以此类推
所以对于一层的一个输入 x_1,总共的公式是:
为什么必须“加起来”?
拿一个特别简单的函数:
这里 x 通过两条路影响 L:
和:
所以:
不是选其中一个。
而是两个影响相加。
神经网络也是一样。
一个输入连接到多个神经元:
x
├→ 神经元1
├→ 神经元2
└→ 神经元3
三个神经元最后都会影响 Loss。
所以:
说了这么多,Layer的backward()到底干什么呢?
它要先收到下一层给他的三个神经元的梯度,然后把每个梯度分发给每个神经元
每个神经元通过自己的backward()更新自己的权重和偏置,并且计算Loss对这个神经元各个输入的梯度,返回出去给上一层,由于当前层的输入就是上一层的输出,所以这些输入对Loss的梯度也就成为了上一层输出对 Loss 的梯度。这样一层一层向前传递,反向传播就成立了
Warning
一定要用老权重算完梯度再更新成新权重
OK!接下来改代码!
首先要先修改Neuron的backward()让它具备计算并返回Loss对当前神经元输入的影响
class Neuron():
    def __init__(self, weights, bias):
        self.weights = weights
        self.bias = bias

    def ReLU(self, x):
        return max(0, x)

    def forward(self, inputs):
        self.inputs = inputs #保存输入,backward时还得用
        z = 0
        for x, w in zip(inputs, self.weights):
            z += x * w
        z += self.bias

        self.z = z #保存z
        self.haty = self.ReLU(z) # 保存haty

        return self.haty

    def ReLU_derivative(self, z):
        if z > 0:
            return 1
        else:
            return 0

    def backward(self, output_gradient, learning_rate):
        # 需要真正的结果y,还有学习率eta,把正确答案y和Loss的计算直接变为output_gradient,表示从后一层的backward返回值中直接拿梯度
        input_gradient = []
        dhaty_dz = self.ReLU_derivative(self.z)
        dL_dz = output_gradient * dhaty_dz

        #更新权重
        for i in range(len(self.weights)):
            dz_dwi = self.inputs[i]
            dL_dw = dL_dz * dz_dwi

            #计算Loss对当前这个神经元的当前输入的梯度
            input_gradient.append(dL_dz * self.weights[i]) #一定要在更新权重之前计算输入梯度!

            self.weights[i] -= learning_rate * dL_dw

        #更新偏置
        dz_db = 1
        dL_db = dL_dz * dz_db

        self.bias -= learning_rate * dL_db

        return input_gradient
然后写Layer的backward(),得到下一次的返回值,然后给每个神经元分发,再收集每个神经元给回的梯度,最后加一起返回给上一层
class Layer():
    def __init__(self, neurons):
        self.neurons = neurons

    def forward(self, inputs):
        neurons_output = []
        for neuron in self.neurons:
            neurons_output.append(neuron.forward(inputs))

        return neurons_output

    def backward(self,output_gradient,learning_rate):
        input_gradient = [0] * len(self.neurons[0].inputs) #直接节省掉input参数,从任意一个神经元里读取输入数量
        for neuronIdx in range(len(self.neurons)): #遍历这一层的每个神经元
            neuron = self.neurons[neuronIdx] #得到目标神经元

            #把Loss对当前这个神经元输出的梯度交给这个神经元
            #神经元的backward函数将会返回自己的每个输入对Loss产生的梯度贡献
            neuron_backward_gradients = neuron.backward(output_gradient[neuronIdx], learning_rate)
            # 把不同神经元对同一个输入的梯度贡献相加
            for inputIdx in range(len(self.neurons[0].inputs)):
                input_gradient[inputIdx] += neuron_backward_gradients[inputIdx]

        #得到整合了所有神经元输入的梯度组,返回
        #当前层输入=上一层输出
        return input_gradient
OK!现在Layer正确的给神经元分发梯度,也可以整合神经元的梯度啦
现在开始写Network,让Network再Layer层面分发与整合梯度
class Network():
    def __init__(self, layers):
        self.layers = layers

    def forward(self, inputs):
        layers_output = inputs
        for layer in self.layers:
            layers_output = layer.forward(layers_output)

        return layers_output

    def backward(self, output_gradient, learning_rate):
        input_gradient = output_gradient

        #倒着遍历每一层,从最底下往上传播梯度组
        for layerIdx in range(len(self.layers) - 1,-1,-1): #range start stop step
            layer = self.layers[layerIdx] #得到对应layer
            input_gradient = layer.backward(input_gradient, learning_rate) #调用layer的backward,由于是逆向遍历,所以现在的input_gradient其实是下一层(相对更靠近输出层)的backward给回的梯度
至此,Neuron,Layer,Network的正向运算与反向传播,搭建完成
下面实例化一个神经网络吧~
为了测试多层网络的前向传播和反向传播,这里先搭建一个结构较小的网络:
其中:
- 第一个 2:输入层有 2 个输入节点;
- 第二个 2:第一隐藏层有 2 个神经元;
- 3:第二隐藏层有 3 个神经元;
- 第三个 2:第三隐藏层有 2 个神经元;
- 最后的 1:输出层有 1 个神经元。
开干!
train_data = [
    (1,1,1),
    (0,1,0),
    (1,0,0),
    (0,0,0)
]

network = Network([
    Layer([
        Neuron([0.5,0.5],0.5),
        Neuron([0.5,0.5],0.5)
    ]),
    Layer([
        Neuron([0.5,0.5],0.5),
        Neuron([0.5,0.5],0.5),
        Neuron([0.5,0.5],0.5)
    ]),
    Layer([
        Neuron([0.5,0.5,0.5],0.5),
        Neuron([0.5,0.5,0.5],0.5) #第三层的权重必须变成三个,因为上一层有三个神经元
    ]),
    Layer([
        Neuron([0.5,0.5],0.5)
    ])
])

for epoch in range(20000):
    for sample in range(len(train_data)):
        haty = network.forward([train_data[sample][0], train_data[sample][1]]) #得到神经网络最终给出的答案,计算Loss
        dL_dhaty = 2*(haty[0]-train_data[sample][2])
        network.backward([dL_dhaty],0.01) #从这里传入梯度的时候传入一个长度为1的列表,因为输出层只有一个神经元

print(network.forward([train_data[0][0], train_data[0][1]]))
print(network.forward([train_data[1][0], train_data[1][1]]))
print(network.forward([train_data[2][0], train_data[2][1]]))
print(network.forward([train_data[3][0], train_data[3][1]]))
这里一定要特别注意神经网络的权重数量问题,这里设置了四层Layer,第二层有三个神经元,所以第三次的两个神经元每层要有三个输入,如图
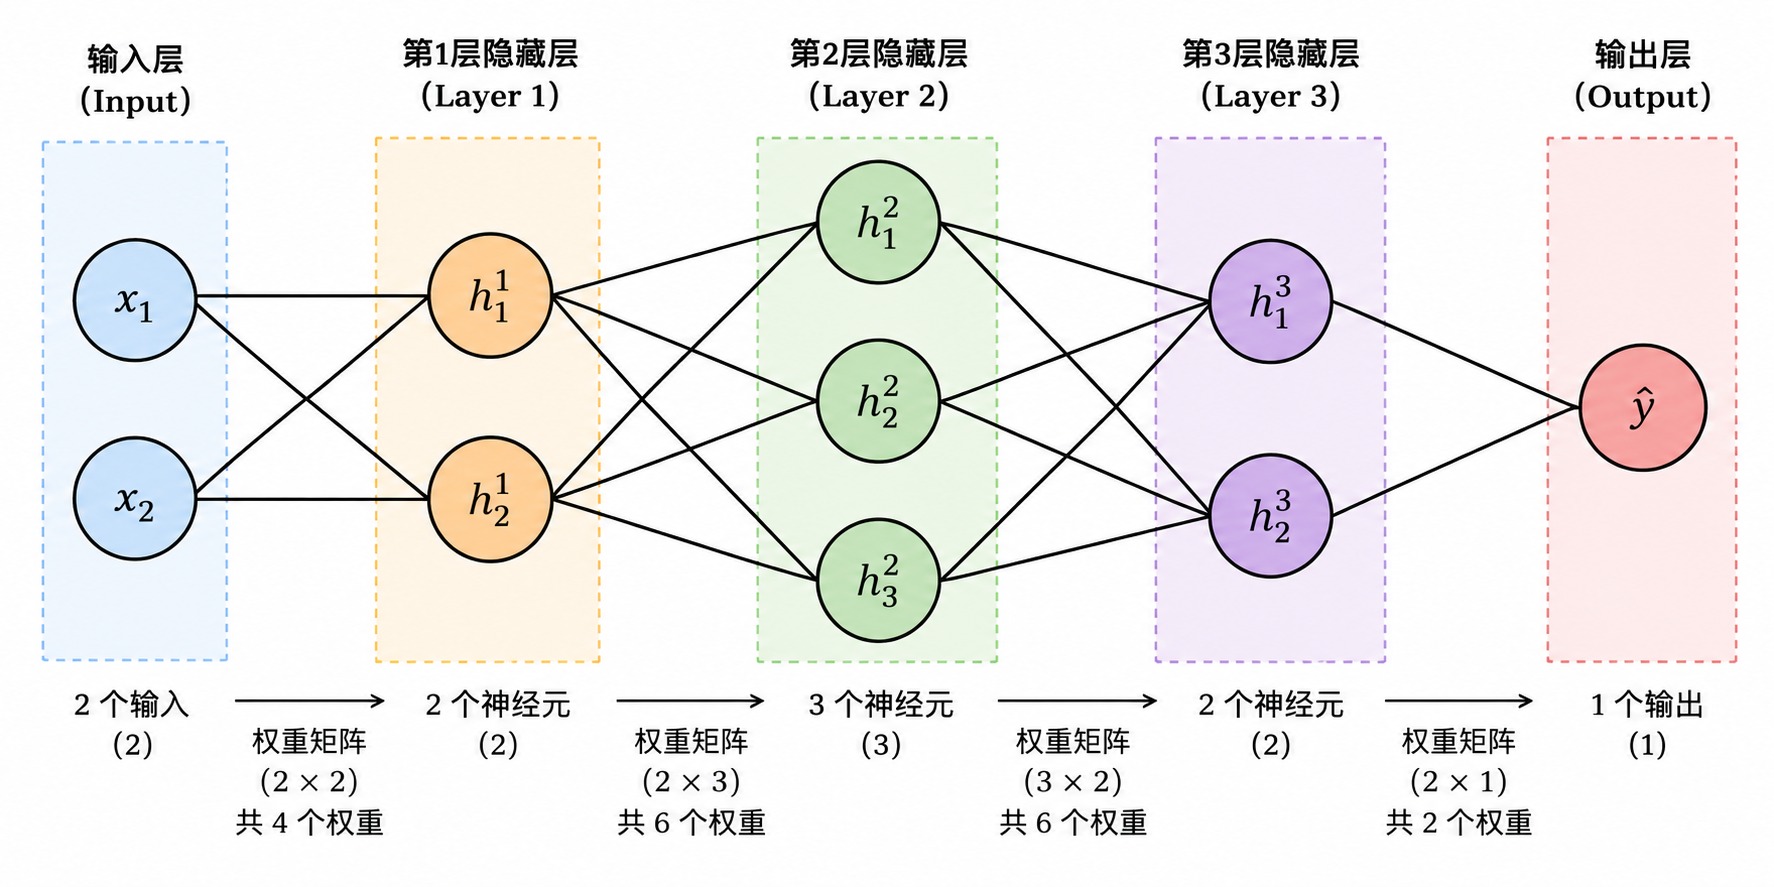
有多少输入就有多少权重
最终训练结果如下
python -u "j:\99的博客\AttentionIsAllYouNeed\MLP.py"
[0.9999999999999987]
[0]
[1.1102230246251565e-15]
[0]
多层 MLP 和单个神经元最终都成功学习了 AND 运算,输出都非常接近理论值 0 和 1。MLP 的部分输出在数值上更接近目标值,但这种 10^{-15} 量级的差异基本属于浮点数误差,不能据此认为 MLP 的训练效果显著优于单个神经元。
但是按理来说多层神经元应该比单个神经元能力多多了啊
GPT提出换用XOR,也就是异或运算试试看
更改train_data然后用两种方法重新开始训练
train_data = [
    (1,1,0),
    (0,1,1),
    (1,0,1),
    (0,0,0)
]

neuron = Neuron([0.5,0.5],0.5) #实例化一个神经元~然后给所有权重给一个初始值,就设为0.5吧

for epoch in range(30000):
    for sample in range(4):
        neuron.forward([train_data[sample][0],train_data[sample][1]])
        neuron.backward(train_data[sample][2], 0.01)

for sample in range(4):
    print(neuron.forward([train_data[sample][0],train_data[sample][1]]))

print("------------------")

network = Network([
    Layer([
        Neuron([0.5,0.5],0.5),
        Neuron([0.5,0.5],0.5)
    ]),
    Layer([
        Neuron([0.5,0.5],0.5),
        Neuron([0.5,0.5],0.5),
        Neuron([0.5,0.5],0.5)
    ]),
    Layer([
        Neuron([0.5,0.5,0.5],0.5),
        Neuron([0.5,0.5,0.5],0.5) #第三层的权重必须变成三个,因为上一层有三个神经元
    ]),
    Layer([
        Neuron([0.5,0.5],0.5)
    ])
])

for epoch in range(30000):
    for sample in range(len(train_data)):
        haty = network.forward([train_data[sample][0], train_data[sample][1]]) #得到神经网络最终给出的答案,计算Loss
        dL_dhaty = 2*(haty[0]-train_data[sample][2])
        network.backward([dL_dhaty],0.01) #从这里传入梯度的时候传入一个长度为1的列表,因为输出层只有一个神经元

print(network.forward([train_data[0][0], train_data[0][1]]))
print(network.forward([train_data[1][0], train_data[1][1]]))
print(network.forward([train_data[2][0], train_data[2][1]]))
print(network.forward([train_data[3][0], train_data[3][1]]))
开始训练!
python -u "j:\99的博客\AttentionIsAllYouNeed\MLP.py"
0.1599999999999991
0
0
0
------------------
[0.5002121244846724]
[0.4998725743427884]
[0.4999440043584395]
[0.4996051249246106]
天啊!为什么学不会了!?
多层神经网络竟然学不会,问题出在哪里呢?
因为 XOR 的标签正好是:
平均值:
对于平方误差来说,如果模型只能输出一个差不多固定的值,那么 0.5 恰好就是最优常数预测。
更关键的原因在你的初始化:
Neuron([0.5,0.5],0.5),Neuron([0.5,0.5],0.5)
同一层所有神经元:
- 权重完全一样;
- bias 完全一样;
- 收到的输入完全一样。
那么 forward 时它们输出也永远一样。
比如第一层:
Neuron A: [0.5, 0.5], b=0.5
Neuron B: [0.5, 0.5], b=0.5
输入一样:
所以:
于是:
反向传播时,它们收到的梯度也会因为对称结构而一样,于是:
训练一次以后还是一样。
再训练:
还是一样。
它们一辈子都长得一模一样。
这叫:
所以神经网络不能把同一层所有神经元初始化成完全一样的参数。
不然你虽然表面上写了 3 个神经元,实际上它们干的是完全一样的事,相当于复制粘贴。
这也是为什么真正的神经网络通常要用随机初始化。
GPT解释过后,茅塞顿开!修改神经元和神经网络权重初始化:
train_data = [
    (1,1,0),
    (0,1,1),
    (1,0,1),
    (0,0,0)
]

def rw(count):

    if count == 1:
        return random.uniform(-0.5, 0.5)

    return [
        random.uniform(-0.5, 0.5)
        for _ in range(count)
    ]

neuron = Neuron(rw(2), rw(1)) #实例化一个神经元~然后给所有权重-0.5~0.5的随机值

for epoch in range(30000):
    for sample in range(4):
        neuron.forward([train_data[sample][0],train_data[sample][1]])
        neuron.backward(train_data[sample][2], 0.01)

for sample in range(4):
    print(neuron.forward([train_data[sample][0],train_data[sample][1]]))

print("------------------")

network = Network([
    Layer([
        Neuron(rw(2), rw(1)),
        Neuron(rw(2), rw(1))
    ]),
    Layer([
        Neuron(rw(2), rw(1)),
        Neuron(rw(2), rw(1)),
        Neuron(rw(2), rw(1))
    ]),
    Layer([
        Neuron(rw(3), rw(1)),
        Neuron(rw(3), rw(1)) #第三层的权重必须变成三个,因为上一层有三个神经元
    ]),
    Layer([
        Neuron(rw(2), rw(1))
    ])
])

for epoch in range(30000):
    for sample in range(len(train_data)):
        haty = network.forward([train_data[sample][0], train_data[sample][1]]) #得到神经网络最终给出的答案,计算Loss
        dL_dhaty = 2*(haty[0]-train_data[sample][2])
        network.backward([dL_dhaty],0.01) #从这里传入梯度的时候传入一个长度为1的列表,因为输出层只有一个神经元

print(network.forward([train_data[0][0], train_data[0][1]]))
print(network.forward([train_data[1][0], train_data[1][1]]))
print(network.forward([train_data[2][0], train_data[2][1]]))
print(network.forward([train_data[3][0], train_data[3][1]]))
得到的训练结果:
0
0
0
0
------------------
[0.33328798802883947]
[1.0066657597605764]
[0.33328798802883947]
[0.33328798802883947]
我去这怎么办呜呜呜,GPT说我这是撞上了前面提到的ReLU Dead,她让我把最后一个神经元的激活函数换成Sigmoid
在此之前,他让我每个神经元都打个点
output_neuron = network.layers[-1].neurons[0]

print(
    "z =", output_neuron.z,
    "output =", output_neuron.haty
)
运行四遍,得到结果:
z = -0.18422243332148341 output = 0
z = -0.44705199068033413 output = 0
z = 0.3337361586688892 output = 0.3337361586688892
z = 0.49989797996319696 output = 0.49989797996319696
可以看到,ReLU 在部分样本上进入了负区间,使这些样本对应的输出被截断为 0,同时梯度也会变成 0。
对于 XOR 这种二分类输出,在输出层使用 Sigmoid 会更加合适:它能把输出限制在 0\sim1 之间,同时不会像 ReLU 一样在负半轴直接产生 0 梯度。
隆重介绍!
Sigmoid!!!
它最大的特点:
所以很适合XOR最终输出:
- 接近 0 → 判断为 0
- 接近 1 → 判断为 1
Sigmoid的导数:
给Neuron类加上activation参数,relu表示激活函数使用ReLU,sigmoid表示激活函数使用Sigmoid
class Neuron():
    def __init__(self, weights, bias,activation="relu"):
        self.weights = weights
        self.bias = bias
        self.activation = activation

    def sigmoid(self, x):
        return 1 / (1 + math.exp(-x))

    def sigmoid_derivative(self, x):
        return self.sigmoid(x) * (1 - self.sigmoid(x))

    def ReLU(self, x):
        return max(0, x)

    def forward(self, inputs):
        self.inputs = inputs #保存输入,backward时还得用
        z = 0
        for x, w in zip(inputs, self.weights):
            z += x * w
        z += self.bias

        self.z = z #保存z

        if self.activation == "sigmoid":
            self.haty = self.sigmoid(z) # 保存haty
        else:
            self.haty = self.ReLU(z) # 保存haty

        return self.haty

    def ReLU_derivative(self, z):
        if z > 0:
            return 1
        else:
            return 0

    def backward(self, output_gradient, learning_rate):
        # 需要真正的结果y,还有学习率eta,把正确答案y和Loss的计算直接变为output_gradient
        # 对于输出层,它由 Loss 函数计算
        # 对于隐藏层,它由后面的层反向传播得到
        input_gradient = []
        if self.activation == "sigmoid":
            dhaty_dz = self.sigmoid_derivative(self.z)
        else:
            dhaty_dz = self.ReLU_derivative(self.z)
        dL_dz = output_gradient * dhaty_dz

        #更新权重
        for i in range(len(self.weights)):
            dz_dwi = self.inputs[i]
            dL_dw = dL_dz * dz_dwi

            #计算Loss对当前这个神经元的当前输入的梯度
            input_gradient.append(dL_dz * self.weights[i]) #一定要在更新权重之前计算输入梯度!

            self.weights[i] -= learning_rate * dL_dw

        #更新偏置
        dz_db = 1
        dL_db = dL_dz * dz_db

        self.bias -= learning_rate * dL_db

        return input_gradient
输出:
0.500625780921828
0.5006257809185757
0.49999999999939715
0.499999999996145
------------------
[0.003973229901095833]
[0.9874908529876903]
[0.9874908529876903]
[0.003973229901095833]
z = -5.524194793805875 output = 0.003973229901095833
可以看到神经网络已经成功工作!!!好耶!!!
而且由于单神经元的局限性,一个神经元永远无法学会XOR,因为XOR在平面上是交叉分布的,一个神经元的决策部分只能产生线性的决策边界,不可能有一条直线分开在平面上交叉的四个点
在多次测试后,我发现ReLU Dead还是会偶发,所以打算把ReLU换成Leaky ReLU
def ReLU(self, x): #换成Leaky ReLU
    if x > 0:
        return x
    else:
        return 0.01*x
    # return max(0, x)

def ReLU_derivative(self, z):
    if z > 0:
        return 1
    else:
        return 0.01
还是会偶发性出现类似如下情况
[0.66720386594263]
[0.6670821681118739]
[0.6670820167103273]
[0.007197252325401114]
这里已经不属于 Dead ReLU,因为 Leaky ReLU 在负区间仍然存在梯度。更可能的原因是随机初始化使网络在这次训练中落入了一个较差的解,使部分输入经过隐藏层后得到非常接近的内部表示。
有趣的是,前三个输出都接近:
而对应的三个 XOR 标签恰好为 (0,1,1),其平均值正是:
这说明网络虽然进行了优化,但并没有成功区分这三个样本,而是选择了一个能够降低总体 Loss 的折中输出。
因此,激活函数并不是影响训练结果的唯一因素,神经网络的参数初始化同样非常重要。
而神经网络权重初始化这条路,又是一条新的,任重而道远的道路。
写在最后
天啊我真的又写出了一个神经网络!!!准确来说这个叫多层感知机(Multi-Layer Perceptron)
这个系列的博客本意是想在99的小站上保存自己写的笔记并给我的好朋友分享,如果有问题欢迎随时提出哦~
这次复习,我更加深刻的理解了基本神经网络的工作原理,也让我觉得机器学习真的很美。
感谢你看到这里,也感谢这几天辛苦学习的自己。
晚安,好梦~~
99
2026/10/4
评论(1)